Quando si pensa all’intelligenza artificiale, la mente corre subito a scenari futuristici, a reti neurali enormi, a ChatGPT o a robot che prendano decisioni autonome. Ma se ci sedessimo per la prima volta sui banchi di un’università di eccellenza per studiare Machine Learning, la prima lezione non sarebbe affatto su come scrivere codice, né su come addestrare un algoritmo.
La primissima lezione che si insegna in università è, in realtà, una domanda filosofica e matematica insieme: l'apprendimento automatico è davvero fattibile?
Il titolo della lezione è "The feasibility of learning" (La fattibilità dell'apprendimento). Prima di imparare come far imparare una macchina, dobbiamo capire se e a quali condizioni questo è logicamente possibile.
Ora la svisceriamo e la spieghiamo in modo facile, sintetico ed intuitivo. Partiamo dalle basi.
1. Il Problema dell'Apprendimento (Supervised Learning)
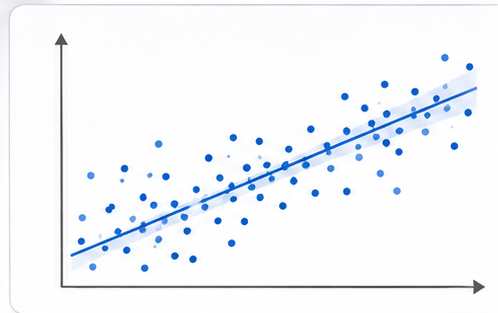
Il cuore del problema è presto detto: dato un insieme di esempi, possiamo trovare una regola che funzioni anche su esempi mai visti?
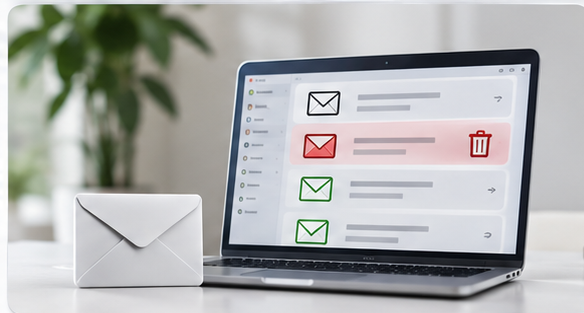
Immaginiamo di voler insegnare a una macchina a riconoscere le email di spam. Per farlo, definiamo i mattoni fondamentali:
- Input (\(X\)): Le caratteristiche dei dati (es. gli attributi dell'email, le parole usate).
- Output (\(Y\)): L'etichetta o il risultato (es. spam / non spam).
- Target Function (\(f\)): La vera regola nascosta che genera i dati. È il "mistero" che vogliamo svelare, ma che non possiamo vedere.
- Dati (\(D\)): Il nostro record storico di esempi, ovvero coppie \((x_1,y_1),(x_2,y_2),\ldots,(x_N,y_N)\).
- Hypothesis (\(g\)): La funzione che il nostro algoritmo impara dai dati. Appartiene a un insieme di possibili modelli chiamato Hypothesis Set (\(H\)).
- Il nostro obiettivo è trovare una \(g\) che sia il più possibile vicina alla vera \(f\).
2. Quando ha senso fare Machine Learning?
L'apprendimento statistico non è una bacchetta magica. Ha senso tentare questa strada solo se si verificano contemporaneamente tre condizioni:
- Esiste un pattern: C'è una regola nascosta che lega input e output. (Se lanciamo una moneta, non c'è pattern da imparare).
- Non possiamo definirlo matematicamente: Se potessimo scrivere una formula esatta per risolvere il problema (es. le leggi della fisica), non ci servirebbe il ML.
- Abbiamo i dati: È il vincolo più restrittivo. Senza dati storici, non c'è apprendimento.
3. La grande domanda filosofica: È possibile imparare?
Qui la lezione tocca un tema profondo.
Dal punto di vista deterministico: NO. Questo è il celebre Problema dell'induzione di Hume (1748). Il fatto che il sole sia sorto tutte le mattine della nostra vita non dimostra matematicamente che sorgerà anche domani. Il passato non garantisce il futuro. Se cerchi una certezza assoluta, l'apprendimento è impossibile.
Dal punto di vista statistico: SÌ. Possiamo imparare in senso probabilistico. Se accettiamo di non avere la certezza assoluta, ma una buona approssimazione, allora l'apprendimento è possibile.
4. L'esperimento dell'Urna (Bin Experiment) - Il cuore matematico
Per capire come funziona questa approssimazione, usiamo una metafora.
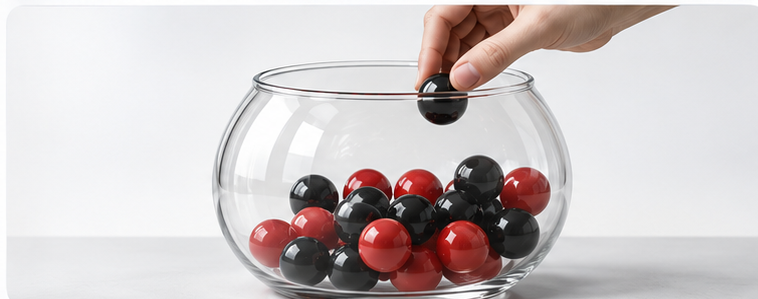
Hai un'urna piena di biglie rosse e nere. La probabilità \(p\) di pescare una biglia nera è sconosciuta.
Estrai \(N\) biglie a caso (campione). La frazione \(\hat p\) di biglie nere nel campione è nota.
Domanda: La nostra \(p\)(campione) dice qualcosa sulla \(p\) reale (l'urna intera)?
Risposta: Se \(N\) è piccolo, il campione può ingannarci (pessimismo). Ma se \(N\) è grande, per la Legge dei Grandi Numeri, \(\hat p\) sarà molto vicina a \(p\)(probabilismo).
5. La Disuguaglianza di Hoeffding e il concetto di P.A.C.
La matematica che formalizza l'esperimento è la disuguaglianza di Hoeffding:
Tradotto: la probabilità che il nostro campione si discosti troppo (\(\epsilon\)) dalla realtà è estremamente bassa, e diminuisce esponenzialmente all'aumentare dei dati (\(N\)).
Concetto di P.A.C. (Probably Approximately Correct): Non avremo mai la certezza assoluta (\(p=\hat p\)), ma avremo un'approssimazione probabilmente corretta.
6. Da "Urna" a "Machine Learning" (Errore In vs Out)
Applichiamo il concetto al ML:
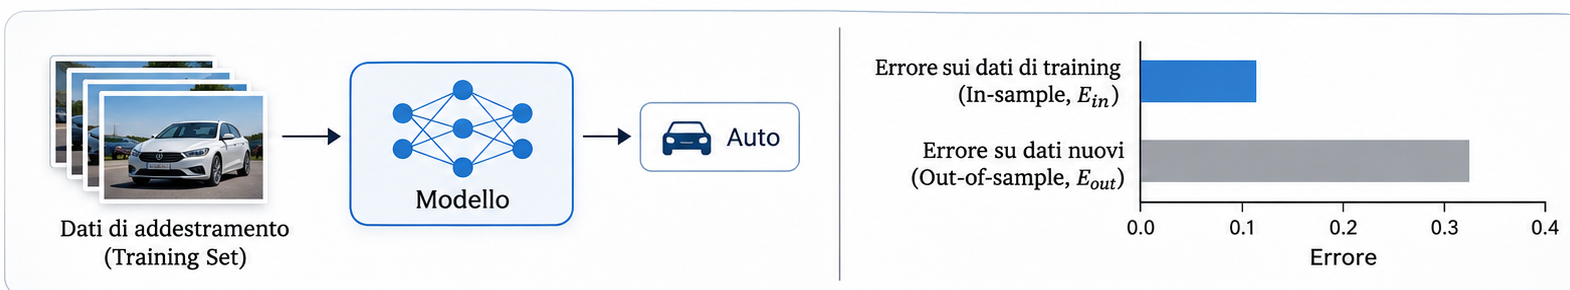
- \(\hat p\) diventa l'\(E_{in}\) (In-sample error): L'errore che il nostro modello \(g\) commette sui dati di addestramento (training set).
- \(p\) diventa l'\(E_{out}\) (Out-of-sample error): L'errore reale che il modello commette su dati mai visti (il vero obiettivo del ML).
Se \(N\) è grande, allora \(E_{in}\approx E_{out}\). Questo è il miracolo del Machine Learning: se il modello va bene sui dati storici, molto probabilmente andrà bene anche nel mondo reale.
7. Il trucco finale: La Generalizzazione e il numero di Modelli (\(M\))
C'è un problema. La formula vista prima vale per un solo modello. Ma in ML, noi testiamo tanti modelli (l'Hypothesis Set \(H\) ha \(M\) modelli possibili) per trovare il migliore.La disuguaglianza si aggiorna così:
\(M\) è il numero di modelli candidati (la complessità del nostro spazio di ricerca).
Più \(M\) è grande (es. reti neurali enormi), più è probabile trovare un modello che va bene sui dati di training (\(E_{in}\) basso) ma fallisce nel mondo reale (\(E_{out}\) alto). Questo si chiama overfitting.
Cosa devi portarti a casa (I Takeaways della prima lezione)
- L'apprendimento non è un processo deterministico, ma probabilistico (Hume).
- Il Machine Learning funziona per approssimazione (PAC), non per certezza.
- La quantità di dati (\(N\)) è tutto: più dati hai, più \(E_{in}\)(addestramento) sarà simile a \(E_{out}\)(realtà).
- La complessità del modello (\(M\)) è un'arma a doppio taglio: più modelli hai a disposizione, più è facile "barare" sui dati di training. C'è sempre un trade-off tra la complessità del modello e la quantità di dati necessari.
- L'obiettivo del ML non è minimizzare l'errore sui dati passati, ma garantire che il modello generalizzi bene sul futuro.
Conclusione: La profonda eleganza della prima lezione
A prima vista, questa lezione sembra pura astrazione matematica: disuguaglianze, urne, campioni e formule. Ma se grattiamo la superficie, scopriamo che la prima lezione di Machine Learning è in realtà un trattato di filosofia travestito da informatica.
È un passaggio straordinariamente affascinante perché fa una cosa rara: distrugge il mito dell'IA come una macchina onnisciente che "conosce" la verità. Ci insegna che l'intelligenza artificiale non è un oracolo infallibile. È una scommessa. È l'arte di fare previsioni sul futuro basandosi su frammenti di passato, accettando l'incertezza come condizione necessaria per imparare.
Ci ricorda che la vera forza del Machine Learning non risiede nell'aver trovato la formula magica della conoscenza, ma nell'aver accettato l'umile, profonda e umanissima verità di Hume: non possiamo avere certezze assolute, ma possiamo costruire modelli che funzionano, a patto di avere abbastanza dati e la lucidità di non complicarli inutilmente.
E forse, a pensarci bene, è un principio che va ben oltre l'informatica: è la stessa elegante fragilità con cui noi esseri umani impariamo qualcosa di nuovo ogni giorno, scommettendo sul domani sulla base di ciò che abbiamo compreso ieri.
— Anass El Fares