Nella prima lezione abbiamo scoperto una verità scomoda ma affascinante: l'apprendimento automatico non è una formula magica per scoprire la verità assoluta. È una scommessa probabilistica. Abbiamo imparato che se abbiamo abbastanza dati e un modello adeguato, possiamo essere ragionevolmente certi che la macchina si comporterà bene anche di fronte a situazioni mai viste.
Ma qui si apre un nuovo, insidioso problema. Come scegliamo la forma esatta del nostro modello? Se il nostro modello è troppo semplice, non coglierà le sfumature della realtà. Se è troppo complesso, rischierà di "imparare a memoria" i dati passati, perdendosi di fronte al futuro.
Il compromesso tra Bias e Varianza (The Bias/Variance Trade-off). Una lezione che ci insegna che, in Machine Learning (e nella vita), non esiste il modello perfetto, ma solo il modello giusto per il livello di complessità che siamo disposti a gestire. Svisceriamola insieme.
1. L'obiettivo (che non possiamo misurare)
Quando addestriamo una macchina, il nostro vero obiettivo non è farla andare bene sui dati che le abbiamo dato in pasto. Il nostro obiettivo è minimizzare l'errore sul futuro, quello che chiamiamo errore out-of-sample (\(E_{out}\)). Vogliamo che la macchina indovini la vera regola nascosta del mondo (\(f\)).
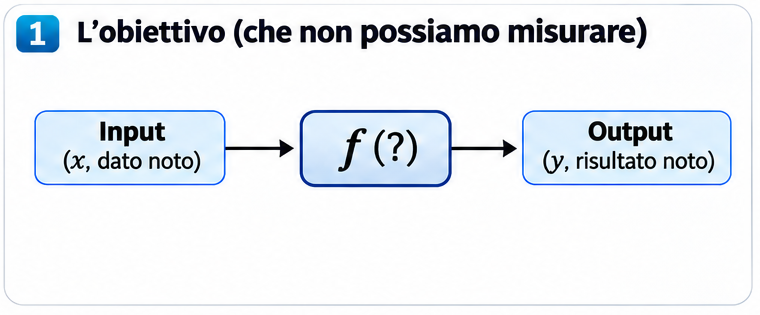
C'è un piccolo problema: l'errore sul futuro non lo conosciamo e non possiamo calcolarlo, perché non abbiamo i dati del futuro. Possiamo solo misurare l'errore sui dati passati, l'errore in-sample (\(E_{in}\)). La domanda è: come facciamo a sapere se un modello che va benissimo sui dati passati continuerà a fare bene anche domani?
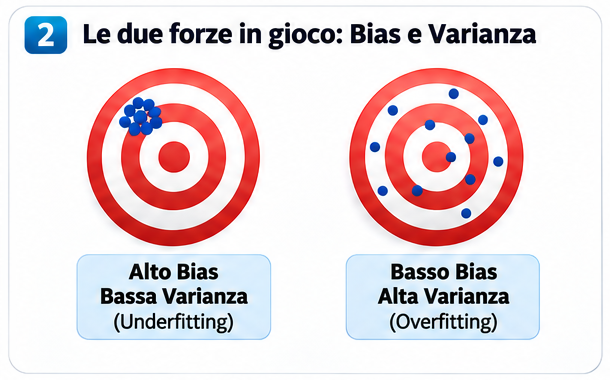
2. Le due forze in gioco: Bias e Varianza
Per capire come un modello sbaglia, in matematica si scompone l'errore in due forze fondamentali, che rappresentano due modi diversi (e opposti) di essere stupidi.
- Il Bias (Distorsione): È l'errore strutturale. Misura quanto la "media" delle nostre previsioni è lontana dalla verità. Un modello con alto Bias è come un orologio rotto che segna sempre le 3:00. Può essere precisissimo, ma è inutile. Sottostima la complessità del mondo (Underfitting).
- La Varianza: È l'instabilità. Misura quanto le nostre previsioni cambiano se cambiamo di poco i dati di addestramento. Un modello con alta Varianza è come una banderuola al vento: basta un soffio (un nuovo dato) e cambia completamente idea. Sovrastima la complessità del mondo (Overfitting).
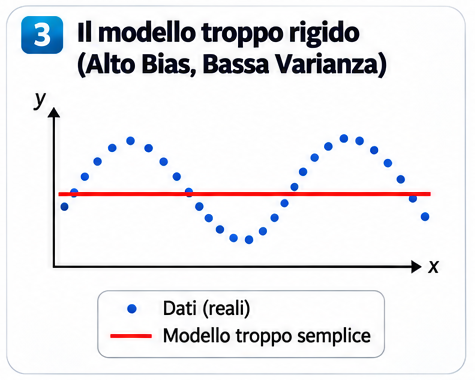
3. Il modello troppo rigido (Alto Bias, Bassa Varianza)
Immagina di scegliere un insieme di modelli (il nostro Hypothesis Set) veramente piccolo, quasi senza parametri. Ad esempio, immagina di voler prevedere l'andamento del mercato azionario usando solo una linea retta orizzontale (un modello costante).
Il modello è solidissimo, non si spaventa per le fluttuazioni: dà sempre la stessa risposta. Ma è cieco. Non riesce a catturare la curva reale dei dati. Questo è il regno del Bias elevato. Guardando i dati, il modello medio è tragicamente lontano dalla vera funzione f. È un pregiudizio cognitivo: rifiutare la complessità a priori.
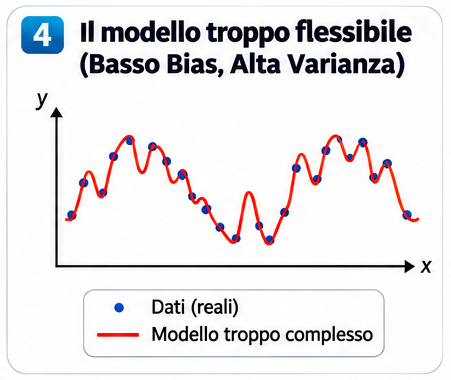
4. Il modello troppo flessibile (Basso Bias, Alta Varianza)
All'estremo opposto, immagina di scegliere un insieme di modelli gigantesco, con migliaia di parametri (come una complessa rete neurale). Questo modello è così flessibile da poter passare esattamente per ogni singolo punto dei nostri dati storici. Non c'è un Bias quasi per niente: sul training set, l'errore è vicino allo zero.
Ma appena gli mostri un dato nuovo, crolla. Ha "imparato a memoria" anche il rumore di fondo, gli errori di misurazione, le casualità. Basta che il dataset cambi di poco (un dato in più o in meno) e il modello traccia una linea completamente diversa. È il regno della Varianza elevata. Come un perfezionista che va nel panico al minimo imprevisto.
5. Il compromesso (Il Trade-off)
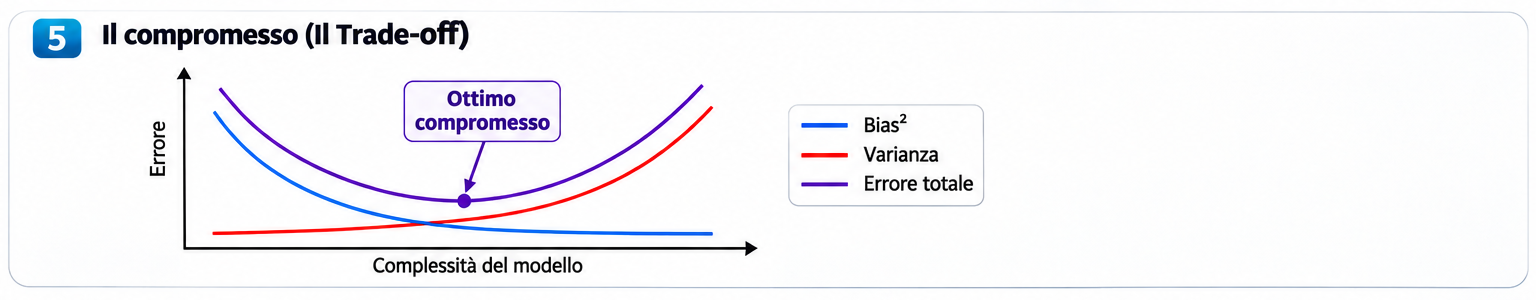
La matematica (e l'esperienza) ci dice una cosa crudele: non possiamo minimizzare entrambi contemporaneamente. Se rendiamo il modello più semplice per ridurre la Varianza, aumenterà il Bias. Se lo rendiamo più complesso per ridurre il Bias, impazzirà la Varianza.
La vera bravura del Data Scientist non è trovare il modello con zero errori, ma trovare quel "punto di equilibrio" (il Trade-off, appunto) che minimizza la somma dei due errori. Scegliere l'insieme di ipotesi giusto (\(H\)) è l'atto più importante e filosofico di tutto il Machine Learning. È il compromesso tra la rigidità del dogma e il caos dell'iper-sensibilità.
Cosa devi portarti a casa (I Takeaways della lezione)
- L'errore reale è invisibile: Possiamo solo misurare l'errore sul passato (\(E_{in}\)) e sperare che sia una buona approssimazione del futuro.
- Il Bias è la cecità: Un modello con troppo Bias è troppo semplice per capire il mondo.
- La Varianza è la fragilità: Un modello con troppa Varianza impara a memoria il passato e fallisce sul futuro.
- Il Trade-off è inevitabile: Ogni volta che aggiungiamo complessità per ridurre l'errore strutturale, aumentiamo l'instabilità.
- Scegliere è tutto: La chiave della generalizzazione non è l'algoritmo in sé, ma la scelta dell'ambiente in cui farlo operare (la selezione dell'Hypothesis Set \(H\)).
Conclusione: La lezione che vale per le macchine e per gli esseri umani
A prima vista, il "Bias-Variance Trade-off" sembra un arido teorema di statistica per ingegneri. Ma se lo osserviamo da lontano, scopriamo che è una delle più potenti metafore del nostro tempo. Descrive esattamente il modo in cui anche noi esseri umani proviamo a capire il mondo.
Nella nostra vita, il Bias è il pregiudizio: la rigidità di chi si chiude in una singola visione del mondo (un modello troppo semplice), rifiutando la complessità e finendo per non capire nulla di ciò che accade. La Varianza, al contrario, è la superficialità di chi cambia idea a ogni notizia, di chi si fa trascinare dall'ultimo tweet o dall'ultima moda, senza mantenere una traiettoria stabile (un modello troppo flessibile).
La lezione profonda del Machine Learning è che la vera intelligenza non è l'onnipotenza. Non esiste un modello che non sbaglia mai. La vera intelligenza è la capacità di trovare un equilibrio dinamico tra la necessità di semplificare per capire, e il coraggio di rimanere flessibili per non soccombere ai dati nuovi.
È l'arte di accettare di non avere la verità in tasca, costruendo però una bussola abbastanza semplice da essere capita, e abbastanza sensibile da non perdersi nel rumore del mondo.
— Anass El Fares